Bonsai 2 : l’IA de 27 milliards qui tient dans 5,9 Go
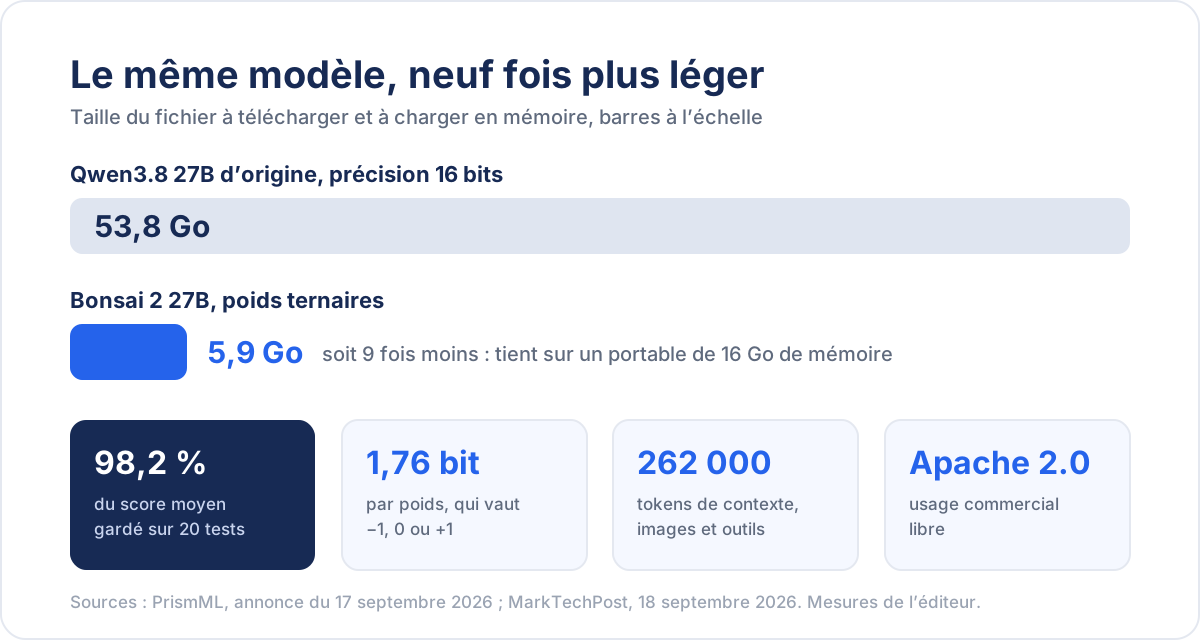
Un modèle d’IA de 27 milliards de paramètres tient désormais dans un fichier de 5,9 Go. Le 17 septembre 2026, la société américaine PrismML a publié Bonsai 2 27B, une version du modèle open source Qwen3.8 27B compressée neuf fois, qui conserve selon elle 98,2 % des scores de l’original et tourne sur un ordinateur portable doté de 16 Go de mémoire. Pour une PME, c’est une IA de bon niveau qui fonctionne sans abonnement et sans qu’aucune donnée quitte la machine. Avec deux réserves : les mesures viennent de l’éditeur, et la compression coûte cher sur les tâches les plus longues.
Ce que PrismML a publié
PrismML est une jeune société issue de Caltech, soutenue notamment par Khosla Ventures, Google et Samsung. Son annonce du 17 septembre porte sur un seul objet : le modèle Qwen3.8 27B, qu’Alibaba a publié en août, réduit à une fraction de sa taille.
- 5,9 Go au lieu de 53,8 Go. Le fichier est neuf fois plus petit que la version d’origine en précision 16 bits.
- 1,76 bit par poids. Chaque paramètre du modèle ne prend plus que trois valeurs possibles : −1, 0 ou +1. C’est ce qu’on appelle un modèle « ternaire ».
- Les capacités sont conservées. Contexte de 262 000 tokens, lecture d’images, appel d’outils pour les usages d’agent.
- Licence Apache 2.0. Usage commercial libre, sans redevance. Les fichiers sont sur Hugging Face.
La première génération, sortie le 14 juillet 2026, gardait environ 95 % des performances de l’original. La seconde annonce 98,2 %, en moyenne sur vingt tests.
Sur quelles machines, à quelle vitesse
D’après le test détaillé de MarkTechPost, il faut au minimum un portable avec 16 Go de mémoire, ou une carte graphique de 24 Go. Les débits mesurés par PrismML : 143 tokens par seconde sur une carte Nvidia RTX 5090, 96,7 sur une RTX 4090, 46,8 sur un Mac M5 Max et 27,7 sur un M5 Pro. À titre de repère, une trentaine de tokens par seconde correspond à un texte qui s’affiche plus vite qu’on ne le lit.
L’installation reste un geste technique. Le modèle ne fonctionne pas avec la version standard de llama.cpp, le moteur le plus répandu pour l’IA locale : il faut la variante fournie par PrismML, ou le format MLX sur Mac. Un script lance ensuite une interface de discussion dans le navigateur, sur la machine elle-même. C’est à la portée d’une personne à l’aise avec un terminal, pas encore d’un utilisateur qui attend un installateur en deux clics.
Les limites à connaître avant de s’emballer
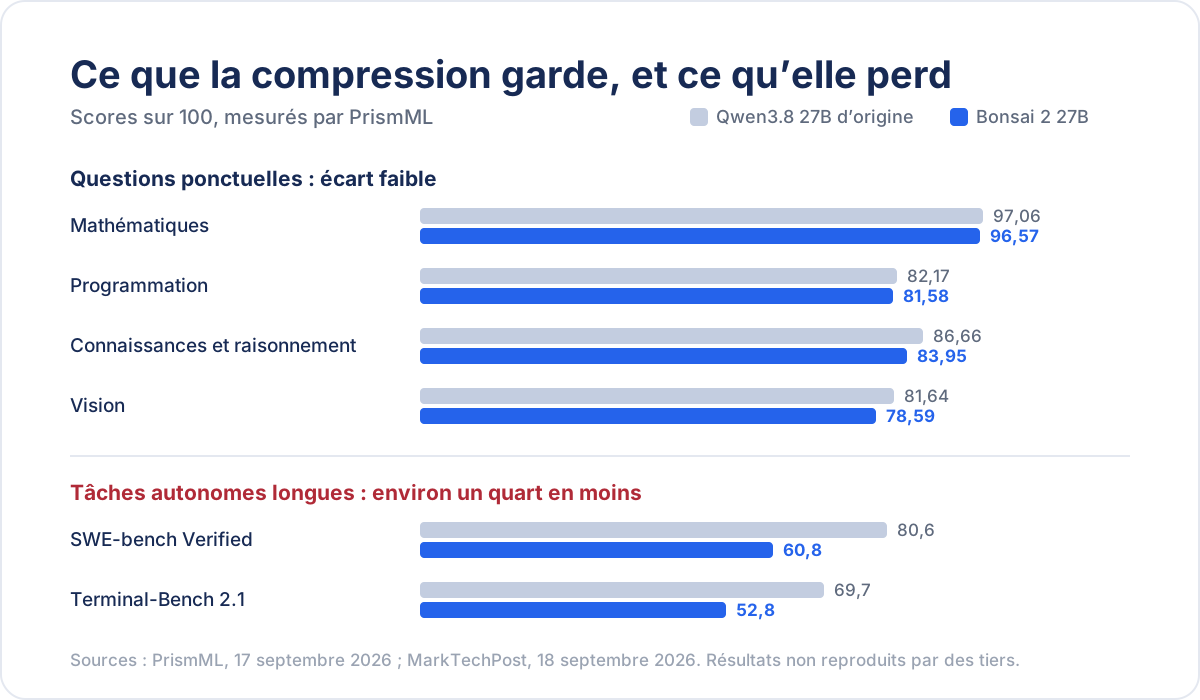
Le chiffre de 98,2 % est une moyenne, et une moyenne cache des écarts. En mathématiques (96,57 contre 97,06) et en programmation courante (81,58 contre 82,17), la version compressée fait jeu égal. Elle recule davantage en connaissances et raisonnement (83,95 contre 86,66) et en vision (78,59 contre 81,64).
Surtout, MarkTechPost relève deux tests où l’écart est net, ceux qui mesurent le travail autonome de longue haleine : 52,8 contre 69,7 sur Terminal-Bench 2.1, et 60,8 contre 80,6 sur SWE-bench Verified. Soit environ un quart de performance en moins. Autrement dit, la compression préserve bien les réponses ponctuelles et moins bien les longues chaînes d’actions, là où les petites erreurs s’accumulent. Le même article précise que ces résultats sont ceux de PrismML et n’ont pas encore été reproduits de manière indépendante. Le détail des écarts par catégorie est repris par AlphaSignal.
Ce que ça change pour une PME
Jusqu’ici, l’IA locale imposait un choix : un petit modèle qui tient sur un portable mais déçoit, ou un bon modèle qui réclame une carte graphique haut de gamme. Bonsai 2 réduit cet écart. Trois usages deviennent raisonnables sur le matériel qu’une petite structure possède déjà :
- Les documents qu’on ne veut pas envoyer dans le cloud. Contrats, dossiers RH, données de patients ou de clients : résumer, reformuler, extraire des informations, sans qu’un fournisseur voie passer le texte. La question se pose d’autant plus que des humains relisent une partie des conversations des assistants en ligne.
- Le travail hors connexion. En déplacement, sur un chantier, dans un train : l’assistant reste disponible.
- Les tâches répétitives à gros volume. Trier des courriels, classer des factures, rédiger des fiches produit : pas de facture à l’usage, seulement l’électricité de la machine.
À l’inverse, pour un agent qui doit travailler seul pendant une heure, ou pour les questions qui exigent le meilleur niveau de raisonnement, les modèles en ligne gardent une nette avance. La bonne organisation n’est pas l’un ou l’autre : c’est de savoir quelle tâche va où, selon la sensibilité des données et la difficulté du travail.
Qu’est-ce qu’un modèle « ternaire » ?
Un modèle d’IA est une immense table de nombres, les poids. D’ordinaire, chacun est stocké sur 16 bits. Dans un modèle ternaire, chaque poids ne peut valoir que −1, 0 ou +1, ce qui demande moins de 2 bits. Le fichier devient beaucoup plus petit et les calculs plus légers ; toute la difficulté est de ne pas dégrader les réponses, ce que PrismML dit obtenir à 98,2 % en moyenne.
Peut-on installer Bonsai 2 avec Ollama ou LM Studio ?
Pas à ce jour, d’après les informations publiées : le format ternaire exige la variante de llama.cpp fournie par PrismML, ou MLX sur Mac. Les sources consultées ne mentionnent pas de prise en charge par Ollama. Si vous débutez en IA locale, mieux vaut attendre cette intégration ou vous faire accompagner pour l’installation.
Choisir entre une IA locale et une IA en ligne, tâche par tâche, est devenu une vraie compétence de dirigeant : elle touche à la confidentialité, au budget et à la qualité du résultat. C’est l’un des sujets travaillés dans les formations IA de Vincent Lévi, à partir des outils et des contraintes réelles de chaque entreprise. Pour savoir si une IA locale a sa place chez vous, contactez l’équipe.